

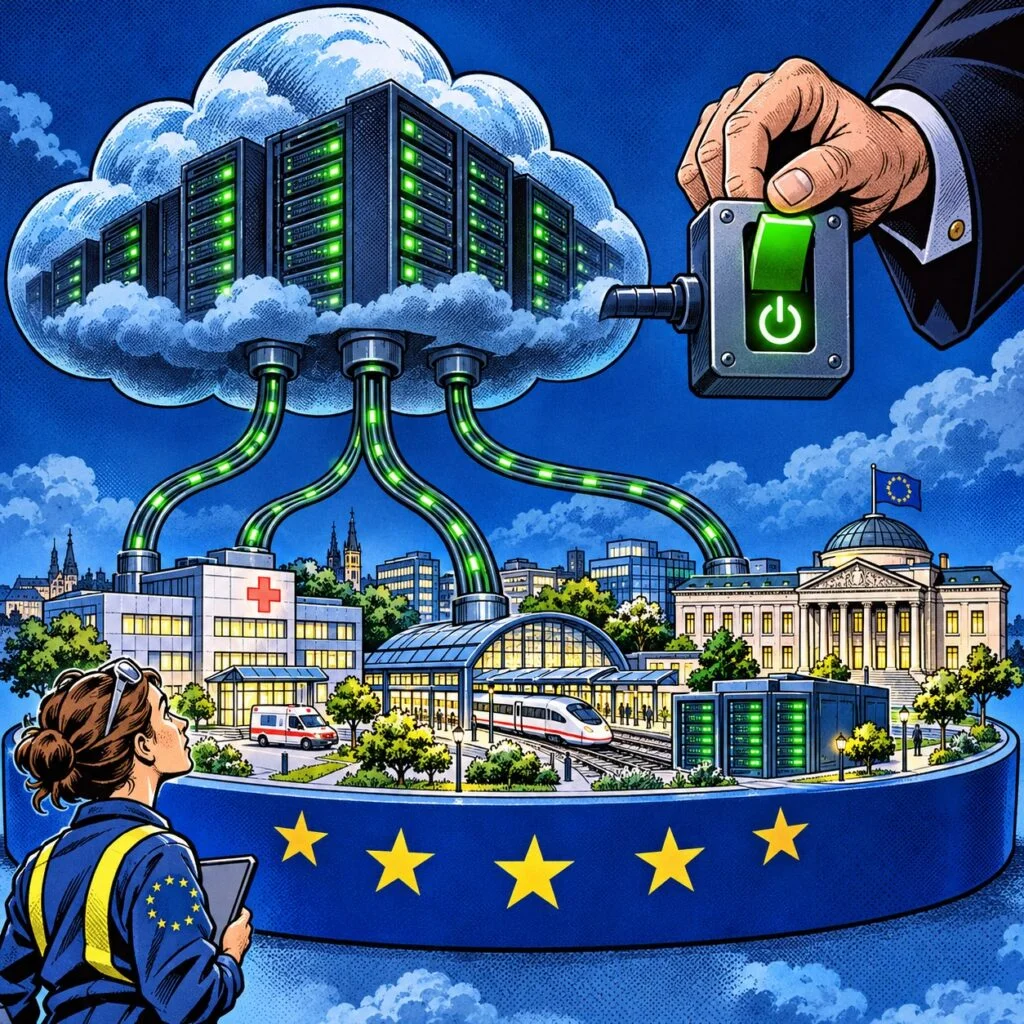
¿Hasta qué punto depende nuestro trabajo de infraestructuras ajenas? Ayer, por lo que se ve, no fue el mejor día para hacer esa pregunta. El proveedor de informática empresarial más importante del mundo, Microsoft, experimentó una disrupción en sus servicios que ha provocado graves interrupciones que se han prolongado durante más de veinte horas y que han afectado a usuarios y compañías de todo el mundo, en lo que se ha convertido en una de las interrupciones del cloud computing empresarial más graves que hemos visto hasta ahora.
Según las primeras explicaciones de la propia compañía, el fallo no es debido a ningún ciberataque, sino a una ampliación de capacidad y a un cambio llevado a cabo posteriormente, aunque falta aún un informe definitivo de las causas. Aparentemente, la caída de varios servidores provocó una sobrecarga en los restantes, aunque quedan aún muchas preguntas que hacer sobre las pruebas que se realizaron, el aislamiento de la incidencia y la recuperación posterior.
Las consecuencias son enormes, y afectan a servicios de todo tipo, muchos de ellos críticos, desde dificultades para coordinar la cobertura de personal en unidades de cuidados intensivos hasta retrasos en servicios judiciales, departamentos de policía, instituciones y empresas de todo tipo. Es muy difícil hacer estimaciones de pérdidas todavía, pero sin duda, hablamos de un desastre con una trascendencia enorme en agregado, y con verdaderos casos graves tomados individualmente, independientemente de que hayamos experimentado interrupciones administrativas o paralización total de servicios.
Hablamos de funcionalidades como el correo electrónico: Outlook es uno de los servicios afectados, y si el correo sirve para coordinar una respuesta, no tenerlo implica dificultades también para organizarla. ¿Cuántas compañías tienen planes de contingencia realistas que incluyan escenarios de continuidad mediante sistemas de comunicaciones independientes con procedimientos adecuadamente ensayados?
También me parece completamente inevitable plantear la relación entre esta caída y una compañía que lleva tiempo reduciendo plantilla mientras dispara sus inversiones en inteligencia artificial, una contradicción que Cory Doctorow denuncia con especial contundencia. Cuando salen profesionales experimentados de una compañía, con ellos puede marcharse también el conocimiento acumulado sobre sistemas antiguos, dependencias y soluciones que desarrollaron y que nunca quedaron suficientemente documentadas, dejando a quienes permanecen la tarea de mantener infraestructuras que no diseñaron y cuyas peculiaridades deben reconstruir bajo presión. ¿Contribuyó este drenaje de talento a prolongar la caída? Ahorrar en quienes saben cómo funciona todo puede salir extraordinariamente caro cuando ese todo deja de funcionar.
Además de las consecuencias inmediatas, cabe plantearse también otras a más largo plazo: ¿dónde queda la confianza en la nube cuando te deja completamente tirado durante más de un día entero y te genera pérdidas tangibles? ¿Cómo de exigente debe ser esa confianza? ¿Qué nivel de transparencia debemos exigir, qué tiempos de recuperación y qué alternativas practicables debemos demandar a nuestros proveedores de infraestructuras como estas? Recientemente, el Bank of England y la Financial Conduct Authority redactaron una carta a cuenta de una disrupción en los servicios de la nube de Google, en la que venían a decir que externalizar la infraestructura no elimina la responsabilidad de las compañías sobre la continuidad de su negocio. Es aún muy pronto para ver si se producen fugas de clientes y para ver si esa desconfianza se traduce en decisiones de compra, pero seguir contratando como si el tamaño del proveedor supusiese algún tipo de garantía de infalibilidad resulta cada vez más difícil de justificar.
Cuando una compañía pasa a ser una infraestructura esencial para hospitales, bancos o administraciones, su fiabilidad deja ya de ser una cuestión a dirimir entre un proveedor y un cliente, y pasa a ser un problema que pagamos todos, y en un escenario de posible guerra híbrida, aunque este caso según Microsoft no esté relacionado con ello, más aún. Según la Unión Europea, reconocer ese problema es sumamente importante, y eso la ha llevado a incluir a Microsoft, Amazon y Google entre los proveedores tecnológicos críticos sujetos a supervisión para el sector financiero bajo la Digital Operational Resilience Act (DORA). Lo que toca ahora es comprobar si esa supervisión consigue que la continuidad sea algo más que una promesa comercial de un preventa acompañada de unos números sobre en un papel, y que comprar tecnología implique también evaluar adecuadamente y con realismo cuánto nos costará seguir funcionando cuando falle.
Nota:https://www.enriquedans.com/
Te puede interesar
Lo más visto